
Знайдіть репліку. Послухайте мовця.
Розділяйте мовлення на репліки з позначеннями мовців і часовими межами. Оберіть Auto або 1–5 мовців і перевірте групування на слух. Потрібні два джерела.
Безкоштовний акаунт · Без платіжної картки · Фонова обробка після завантаження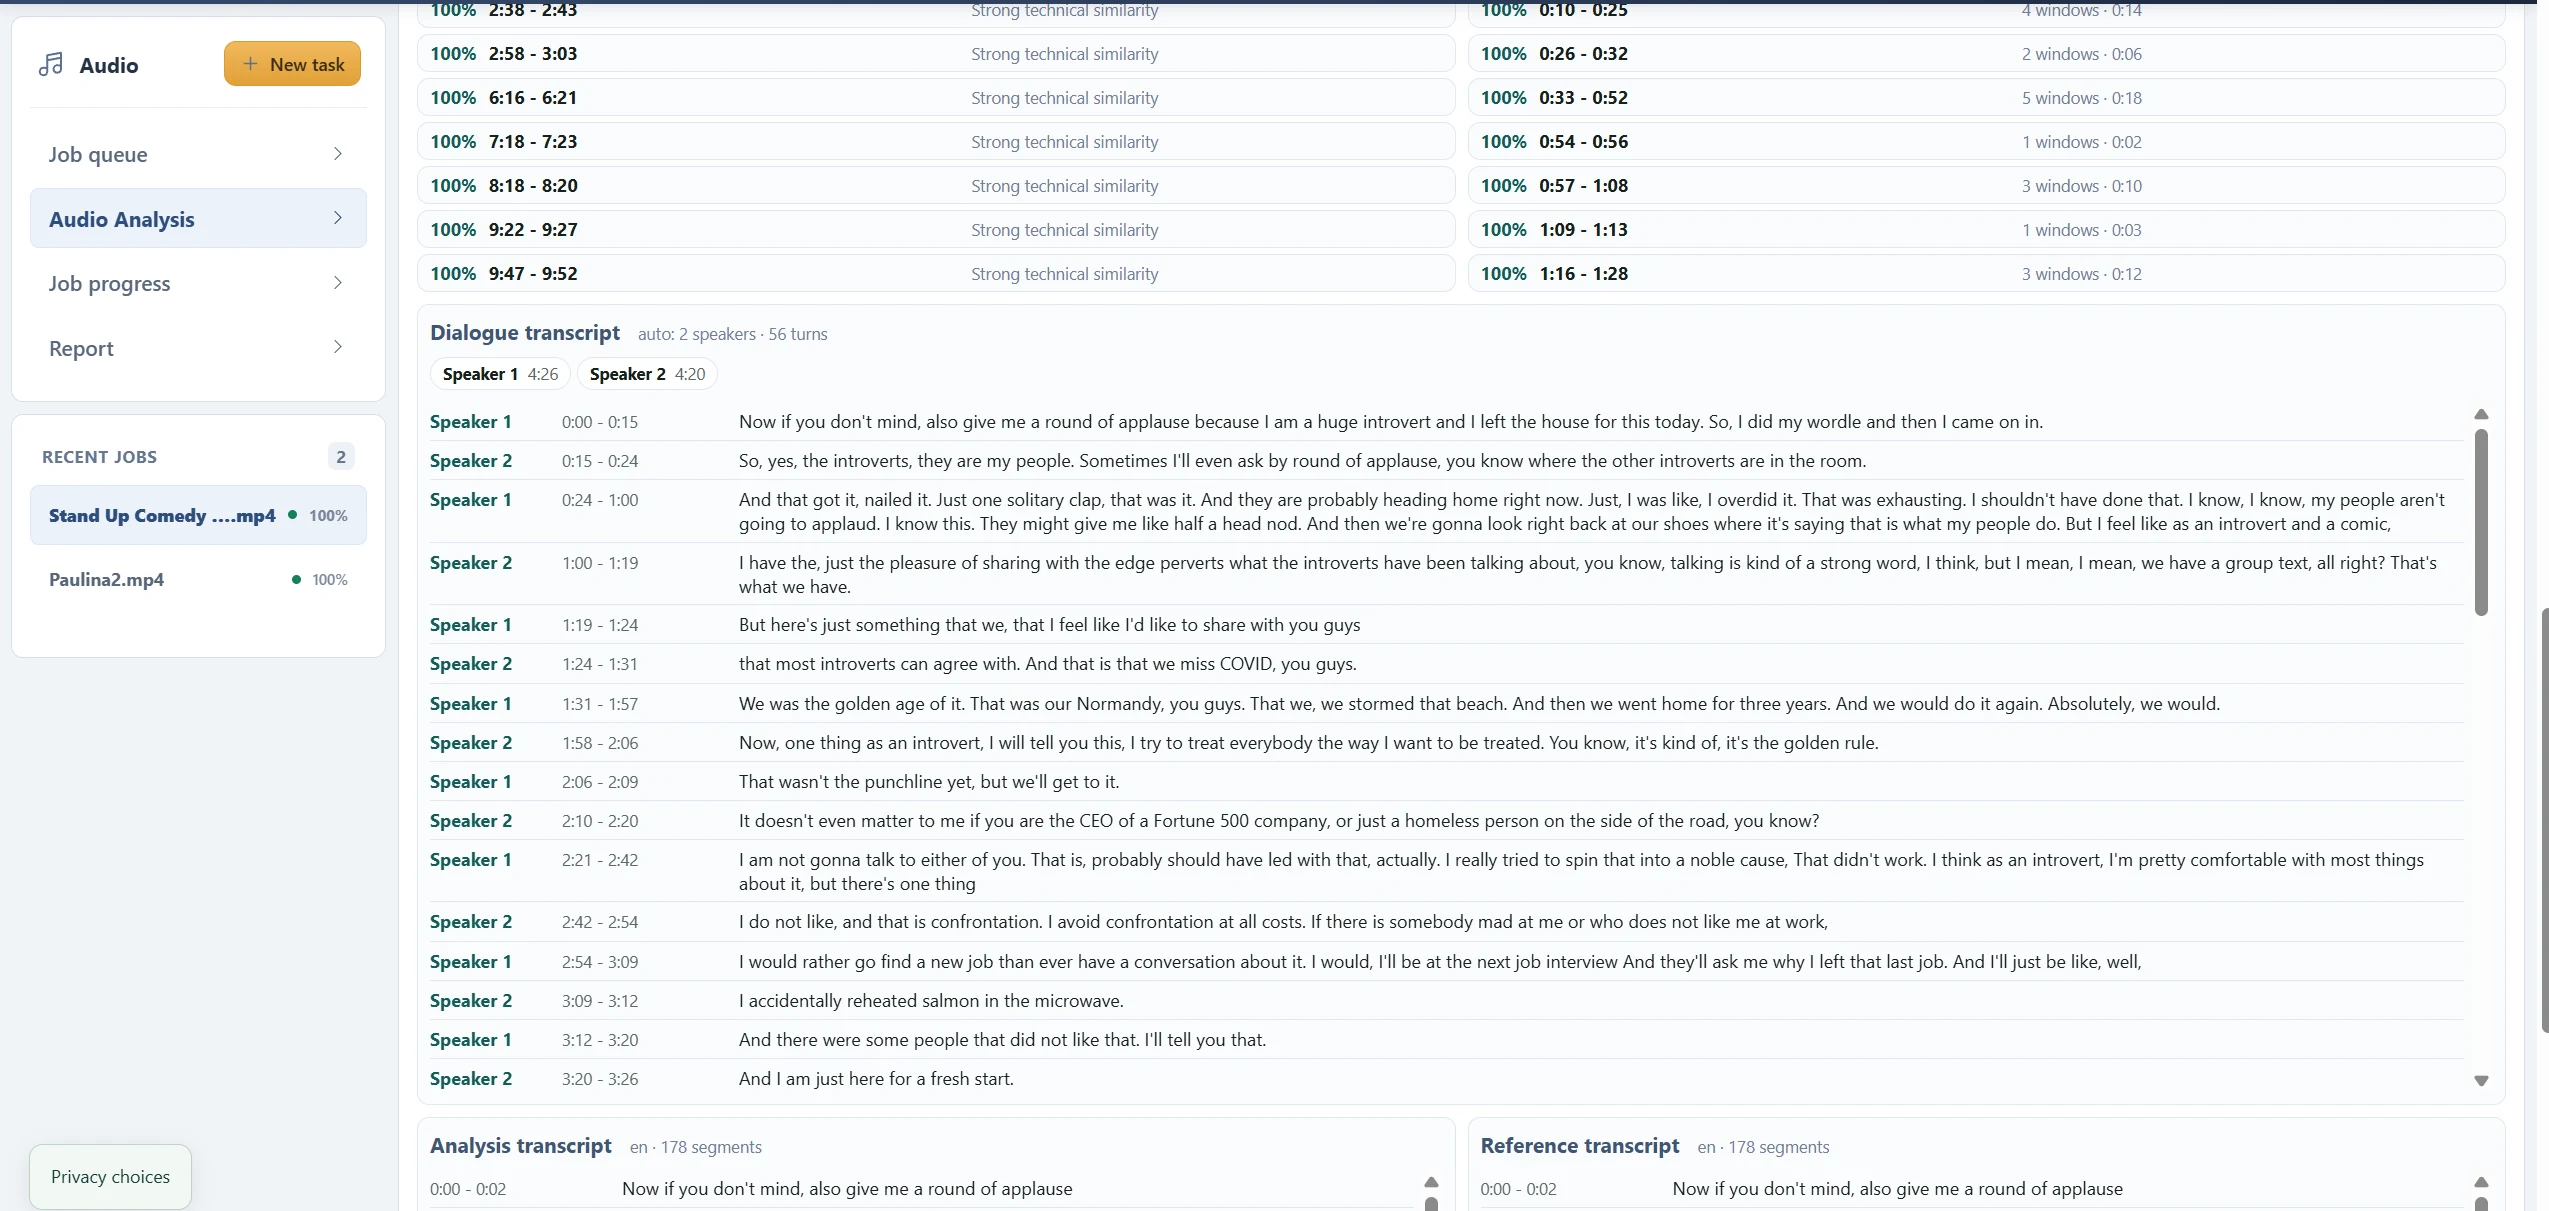
Від двох джерел — до звіту, який можна перевірити.
- 01
Оберіть запис для аналізу
Додайте аудіозапис або оберіть відео й підтвердьте видобування звуку.
- 02
Додайте еталон голосу
Завантажте зразок голосу: у поточному процесі аналізу він обов’язковий.
- 03
Вкажіть кількість мовців
Оберіть автоматичне визначення або відому кількість від 1 до 5 та перевірте обидва джерела.
- 04
Запустіть і стежте за станом
Дочекайтеся завершення завантаження: далі звіт формуватиметься у фоні.
- 05
Читайте й слухайте
Зіставляйте часові позначки, репліки мовців і показники якості з вихідним звуком.
Оберіть Auto або вкажіть кількість мовців.
У режимі Auto групи мовців визначаються за доступними фрагментами мовлення. Якщо ви знаєте їхню кількість, оберіть 1–5 у Speakers in analysis. Задана кількість впливає на групування, але не гарантує правильного розділення всіх голосів.
Одночасне мовлення, сміх, фонові голоси, короткі репліки й зміни якості мікрофона можуть об’єднати різних людей в одну групу або розділити одну людину між кількома позначеннями. Почніть із короткого характерного запису та перевірте кілька реплік на слух.
«Мовець 1» — позначення, а не ім’я.
Нумеровані позначення діють лише в межах цього завдання. Вони не встановлюють особу й не означають ту саму людину в інших завданнях. У прикладі Auto визначив 2 мовців і 56 реплік. Це результат автоматичного групування для перевірки, а не підтверджена кількість учасників.
У тексті діалогу розпізнані слова зіставлено з часовими вікнами мовців. Фрагмент на межі зміни мовця може бути віднесений до групи неточно. Прослухайте сусідні проміжки часу, щоб перевірити справжню зміну голосу.
Розрізняйте поділ за мовцями й порівняння голосів.
Еталонний файл потрібен для порівняння з мовленням в основному записі. Групування мовців і зіставлення з еталоном пов’язані у звіті, проте нумерований мовець не стає автоматично людиною з вашого зразка.
Для змістовного порівняння додайте чистий еталон з одним мовцем і перевірте кілька вікон зі збігами. Цей файл потрібен у поточному майстрі й тоді, коли вас цікавить лише поділ за мовцями. Окремого режиму без еталона поки немає.
Запитання про поділ за мовцями
Чи потрібен еталон, якщо мені потрібен лише текст?
Аналіз голосу використовує еталон для порівняння. Для розшифрування одного запису виберіть транскрибатор.
Чи можна закрити вкладку?
Залишайте вкладку відкритою, доки обидва файли завантажаться й завдання буде надіслано. Далі обробка триватиме у фоні; стан і готовий звіт доступні у списку аудіозавдань.
Які обмеження діють для файлів?
Кожен файл — до 512 МіБ. Основний запис — до 30 хвилин, а еталон має містити щонайменше 3 секунди виявленого мовлення. Також діють обмеження обробки, зберігання та перевірки якості.
Різні завдання. Єдиний звіт із контекстом.
Аналіз аудіо
Аналізуйте мовлення з аудіо чи відео: текст, репліки мовців, порівняння голосів, показники якості й графіки в одному звіті для перевірки.
Аудіо в текст
Перетворюйте записане мовлення на текст із часовими позначками в аналізі аудіо. Зіставляйте слова з репліками мовців і відтворенням джерела.
Відео в текст
Розпізнавайте мовлення із завантаженого відео. Підтвердьте видобування звуку, додайте обов’язковий еталон і перегляньте текст із часовими позначками у звіті.
Порівняння голосів
Порівнюйте основний запис зі зразком голосу. Перевіряйте схожі інтервали мовлення, підсумки за мовцями та якість звуку, перш ніж тлумачити оцінки.
Слухайте уважніше. Читайте з контекстом.
Як знаходити й слухати репліки мовців
Використовуйте позначення мовців, репліки діалогу, схожі інтервали й часові позначки, щоб знаходити та прослуховувати фрагменти в аудіозвіті.
Як читати звіт аналізу аудіо
Розберіться в програвачах джерел, показниках якості, текстах, групах мовців, схожості голосів і графіках звуку в поточному аудіозвіті.
Що означають оцінки схожості голосів
З’ясуйте, що показують найкраща оцінка, медіана п’яти найкращих, тривалість схожого мовлення й підсумки за мовцями. Технічні оцінки не є ймовірністю тотожності особи.
Підтримувані мови розпізнавання мовлення
Перевірте поточну підтримку англійської, української та російської, автоматичне визначення мови й обмеження для багатомовного або нерозбірливого мовлення.
Як працює порівняння голосів: від запису до еталона
Розберіть увесь процес: підготовку джерел, виявлення мовлення, часові вікна, вектори голосу, профілі еталона, оцінку схожості й перевірку за джерелом. Окремо — чинна реалізація CS Match.
Вектори голосу: від i-векторів до ECAPA-TDNN і WavLM
З’ясуйте, як мовлення перетворюється на вектор мовця та чим відрізняються i-вектори, x-вектори, ECAPA, залишкові мережі й WavLM. Чому сумісність ваг, об’єднання ознак і перевірка важливіші за назву вектора.
ECAPA-TDNN і VoxCeleb: навчання, ваги й реальні обмеження
Розберіться в навчанні ECAPA-TDNN, протоколах VoxCeleb, попередньо навчених вагах, аугментації та відтворюваності. Де закінчується застосовність тестових результатів до реальних записів.
Бібліотеки для голосу: SpeechBrain, NeMo, WeSpeaker, Kaldi й pyannote
Порівняйте п’ять інструментаріїв за завданнями, вагами моделей, рецептами навчання, оцінками, поділом за мовцями, вимогами до розгортання й перевіркою. Чому CS Match використовує поточну базову конфігурацію.
Як обрати еталон голосу
Підготуйте корисний еталон: один мовець, достатньо придатного мовлення, незалежні записи, доречні канали й контекст джерела. Як формується профіль CS Match і які його обмеження.
Чому той самий голос відрізняється в телефонах і записах
З’ясуйте вплив мікрофонів, смуги частот, зміни частоти дискретизації, кодеків, приміщення, регулювання підсилення та стереоканалів. Оцінюйте відмінності каналів, не плутаючи їх із відмінностями людей.
Методи поділу за мовцями: кластеризація, накладання й зміни голосу
Розгляньте виявлення мовлення, вектори часових вікон, косинусну кластеризацію, AHC, спектральні методи, VBx і нейромережеву обробку одночасного мовлення. Оцінка якості та чинна реалізація CS Match.
Підготовка аудіо до порівняння: що допомагає, а що змінює голос
Відрізняйте узгоджену підготовку від фільтрації, очищення шуму, зменшення реверберації та розділення джерел. Зберігайте часову шкалу, перевіряйте вимоги моделі й вимірюйте користь змін для порівняння.
Метрики перевірки голосу: FAR, FRR, EER, minDCF і калібрування
Правильно читайте мітки тестових пар, хибні допуски й відмови, ROC і DET, EER, вартість помилок, калібрування та невизначеність. Які межі мають поточні оцінки звіту.
Навчання й оцінка порівняння голосів на реальних записах
Побудуйте відтворюване дослідження: мітки джерел, поділ за мовцями й сеансами, умови тестових пар, базові ваги, адаптація, калібрування, перевірка повних записів і невизначеність результатів.
Голосова біометрія в банках: реєстрація еталона й перевірка клієнта
Дослідіть довірену реєстрацію голосу, перевірку один до одного, запис дзвінків, протидію шахрайству, загрози повторного відтворення й синтезу, стандарти та життєвий цикл. Межі порівняння готових записів.
Перевірка голосу за фразою та за довільним мовленням
Порівняйте фіксовані фрази, запропонований текст і вільне мовлення. Відокремлюйте сценарій взаємодії від моделі, оцінюйте помилки голосу й змісту та розгляньте набори даних і вибір CS Match.
Постачальники голосової біометрії: продукти й підтверджені можливості
Порівняйте Pindrop, NiCE, Phonexia, Veridas і ValidSoft за документованими завданнями, інтеграцією, змістом оцінок і перевіркою якості. Чим комерційні голосові платформи відрізняються від порівняння записів.
Голосові дипфейки й повторне відтворення: окреме завдання виявлення
Чому схожість голосу не підтверджує справжність мовлення? Повторне відтворення, синтез, зміна голосу, AASIST, моделі протидії із самокерованим навчанням, завдання ASVspoof, спільні метрики й обґрунтована оцінка.
Порівняння голосів у контакт-центрах, страхуванні й підтримці
Розгляньте перевірку записів дзвінків і клієнтів: вибір каналу, реєстрацію еталона, переведення дзвінків, пошук підробок, інтерфейси операторів, показники сервісу та межі реалізації.
Порівняння голосів у медіа, архівах і дослідженнях записів
Перевіряйте голоси в інтерв’ю, ефірах і архівах: збереження джерел, зіставлення часових шкал, поділ за мовцями, зв’язки між записами, вибір еталона, порівняльна вибірка та межі висновків.
Розгортання порівняння голосів: CPU, GPU, хмара й зберігання даних
Плануйте аналіз записів на CPU, GPU й у хмарі: витрати етапів, паралельність, точність обчислень, кеш моделей, збої завдань, сховище, строки зберігання й відтворювану оцінку швидкодії.
Чому CS Match використовує ECAPA-TDNN, Silero VAD і faster-whisper
Розберіть реальну аудіоархітектуру CS Match: підготовку джерел, перевірки якості, вікна мовлення Silero, порівняння з еталоном ECAPA, кластеризацію, текст faster-whisper, звіти, очищення й межі резервних механізмів.
Поєднуйте можливості інструментів.
Відкрийте можливості
ваших медіа.
Створити безкоштовний акаунтБез платіжної картки. Почніть з акаунта Free.